 至译
免费文档结构化提取
从 PDF、扫描件、Word、PPT、Excel 中提取标题、段落、表格和图片,输出 Markdown 和 JSON。
PDF 单个文件最多 501 页,每月额度不限;免费任务需要排队。文件较大或着急使用,推荐下载 OmniDoc 桌面客户端,不限页数,无需排队。
如何将 PDF 转换为 Markdown 和 JSON
- 1上传文件登录 OmniDoc 账号后,将文件拖入上方区域,或点击「选择文件」。
- 2开始提取PDF、扫描件和图片经版面分析、文字识别和表格识别处理;Word、PPT、Excel、电子书和网页直接解析文档结构。
- 3下载结果完成后下载 ZIP 压缩包,内含 Markdown、JSON 和图片。
提取效果
同一份报告的第 1 页,提取后得到的 Markdown:标题层级、段落和表格完整保留。
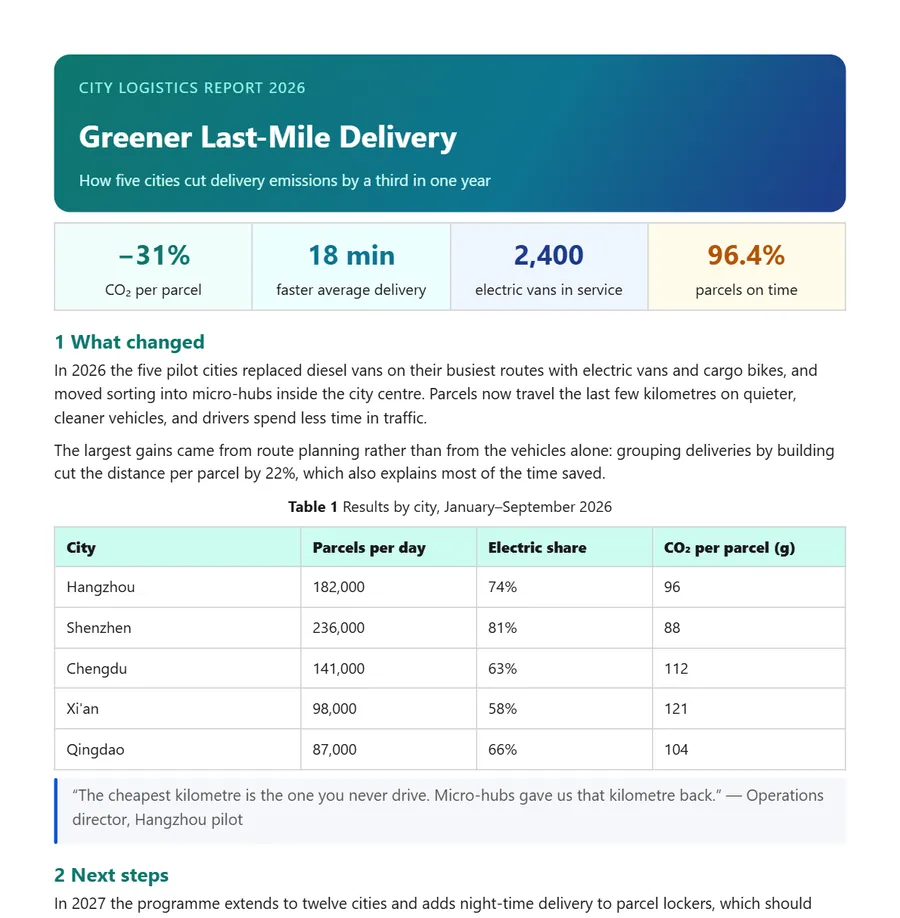
# Greener Last-Mile Delivery

How five cities cut delivery emissions by a third in one year

## 1 What changed

In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, and moved sorting into micro-hubs inside the city centre. …

**Table 1** Results by city, January–September 2026

| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
| Xi'an | 98,000 | 58% | 121 |
| Qingdao | 87,000 | 66% | 104 |
下载的 ZIP 压缩包包含
document.mdMarkdown 全文document.json按阅读顺序排列的结构化数据images/文档中的图片manifest.json文件清单与基本信息
支持的文件格式
| 文件 | 处理方式 |
|---|---|
| PDF、扫描件 PDF、PNG、JPG、WEBP、BMP 图片 | 版面分析、文字识别(OCR)和表格识别 |
| Word、PowerPoint、Excel、CSV | 直接解析文档结构 |
| EPUB 电子书、HTML 网页 | 解析章节和正文结构 |
| Markdown、TXT、SRT、ASS 字幕 | 整理为统一的 Markdown 和 JSON |
常见问题
提取结果包含哪些文件?
一个 ZIP 压缩包,包含 document.md(Markdown 全文)、document.json(结构化数据)、images/(图片)和 manifest.json(文件清单)。
扫描件能提取吗?
可以。PDF 扫描件和图片会先进行文字识别,再整理结构。识别结果请与原文核对,尤其是数字和表格。
免费提取有哪些限制?
PDF 单个文件最多 501 页,每月额度不限。免费任务按提交顺序排队,速度取决于排队情况;我们会尽量保证提取效果,如有不理想之处,敬请谅解。文件较大或着急使用时,推荐下载 OmniDoc 桌面客户端:不限页数,无需排队。
与直接复制文字有什么区别?
提取会保留标题层级、段落、表格和图片之间的关系,得到的是结构化数据,而不只是一段纯文本。
需要登录吗?
需要。使用 OmniDoc 账号登录,注册免费。上传的文件和处理结果仅本人可见。
在哪里下载结果?
处理完成后在本页直接下载。任务在后台运行,离开页面不受影响;再次打开本页并登录,可在「最近的提取」中找到之前的文件。
文件扩展名与实际格式不符怎么办?
系统按文件内容识别真实格式。例如实际为 Word 文档的 .pdf 文件,会按 .docx 处理,结果也以 .docx 返回。旧版 .doc、.xls、.ppt 文件请先另存为 .docx、.xlsx、.pptx。
需要安装软件吗?
不需要,在浏览器中即可使用。页数较多或着急使用时,推荐下载 OmniDoc 桌面客户端(Windows、macOS、Linux):不限页数,无需排队。
OmniDoc 桌面版:流畅不卡,Office 格式百分百支持,新国标直接用
免费桌面客户端,Windows、macOS、Linux 都能装,文件在你自己的电脑上打开、编辑、保存。